
Platforma AI a strojového učení
Data vaší továrny proměněná v rozhodnutí
AI platforma MSF se učí z vašich výrobních dat, aby optimalizovala plány, předvídala problémy s kvalitou, prognózovala poptávku a odhalovala skrytou kapacitu. Tvoří vrstvu inteligence nad všemi moduly MSF.
Vyžádat demoZahájit PoCCo je platforma AI pro výrobu?
Platforma AI pro výrobu využívá strojové učení na výrobních datech k optimalizaci plánů, předvídání problémů s kvalitou, prognóze poptávky a odhalování neobvyklého chování strojů. AI platforma Meta Smart Factory tvoří vrstvu inteligence nad všemi moduly MSF: předpřipravené výrobní modely ladí odborníci MSF na vlastních datech závodu, takže není potřeba interní tým datových specialistů, a každý model nejprve běží ve stínovém režimu, než se jeho upozornění spustí naostro.
Klíčové funkce
V kostce
Technické parametry
- Datový základ
- Podmínkou jsou data z MES; každý další modul (APS, Kvalita, Údržba) odemyká další případy využití AI.
- Vstupy modelů
- Modely s učitelem (významnost proměnných v XGBoost, predikce výstupu pomocí Random Forest) potřebují procesní parametry plus zakódované označení výsledku; autoenkodér LSTM si vystačí se surovými řadami ze senzorů.
- Nasazení
- On-premise nebo privátní cloud, podle vaší volby; vaše výrobní data zůstávají vyhrazená vašim vlastním modelům.
- Výstupní cesta
- Pouze doporučení: na panelu, v reportu nebo jako návrh plánu v APS. Zápis žádaných hodnot zpět do řídicího systému je samostatně zadaná integrace, nikdy ne bezpečnostní blokace.
- Potřeba označených dat
- Modely s učitelem se dimenzují podle počtu správně okódovaných případů na třídu, ne podle měsíců: model zmetkovitosti potřebuje skutečné kódy zmetků, model poptávky několik celých sezónních cyklů.
- Předpoklady pro energetiku
- Měření dost podrobné na rozlišení jednotlivých spotřebičů, váš tarifní kalendář a plánovač, kterému lze plán předat; optimalizuje se výhradně proti cenovým oknům za kWh.
- Práce na straně zákazníka
- Jmenovitý procesní nebo inženýr kvality a pravidelný termín na revizi; ladění a dotrénování dělá MSF, zákazník drží čisté kódy zmetků a prostojů a hlásí změny procesu.
Z platformy: skutečné obrazovky
Časté dotazy
Potřebuji tým datových vědců?
Ne. Modely jsou předpřipravené pro výrobní use case a doladí je experti MSF přímo na vašich datech.
Kde jsou data uložená?
Podle vaší volby lokálně nebo v privátním cloudu. Vaše výrobní data nikdy netrénují modely jiných firem.
Které moduly AI vyžaduje?
Základem jsou data z MES; každý další modul (APS, Kvalita, Údržba) odemyká další případy využití AI.
Kolik historie z výroby AI potřebuje?
Rozhoduje počet označených případů na každou třídu, ne počet odpracovaných měsíců. Model zmetkovitosti se učí z vad, takže linka s nízkou zmetkovitostí může běžet velmi dlouho a pořád nenasbírá dost případů té méně časté třídy, zatímco model prognózy poptávky chce několik celých sezónních cyklů. Starší historie se počítá jen tehdy, pokud stojí na stejném kmeni dílů a stejné struktuře závodu, jakou plánujete dnes. Najděte si proto nejdřív poslední migraci ERP nebo přečíslování dílů. Krátká čistá řada je lepší než dlouhá slepená přes přečíslování.
Funguje prediktivní kvalita i bez kódů zmetků?
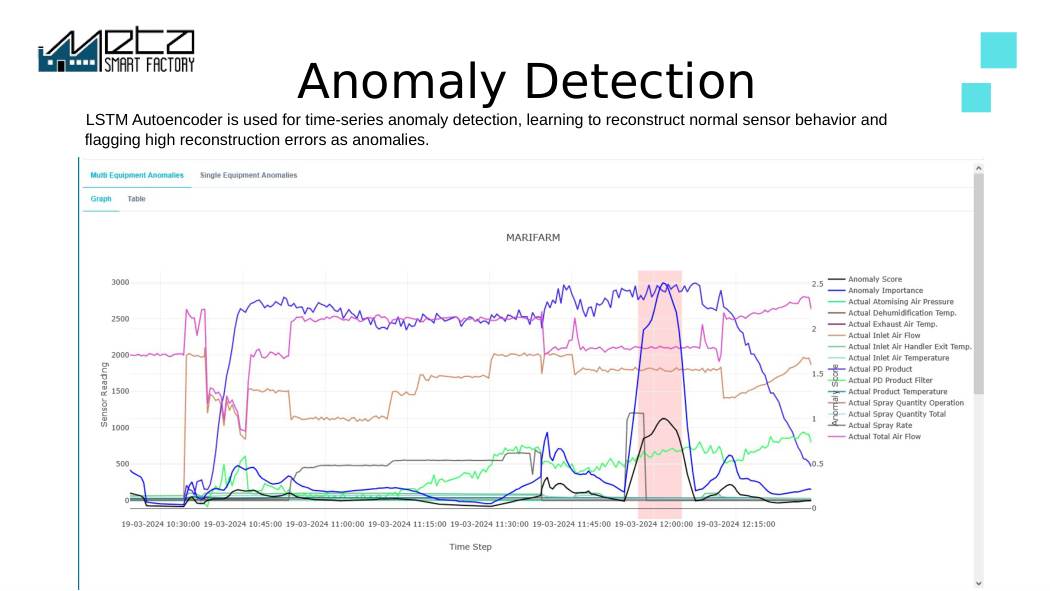
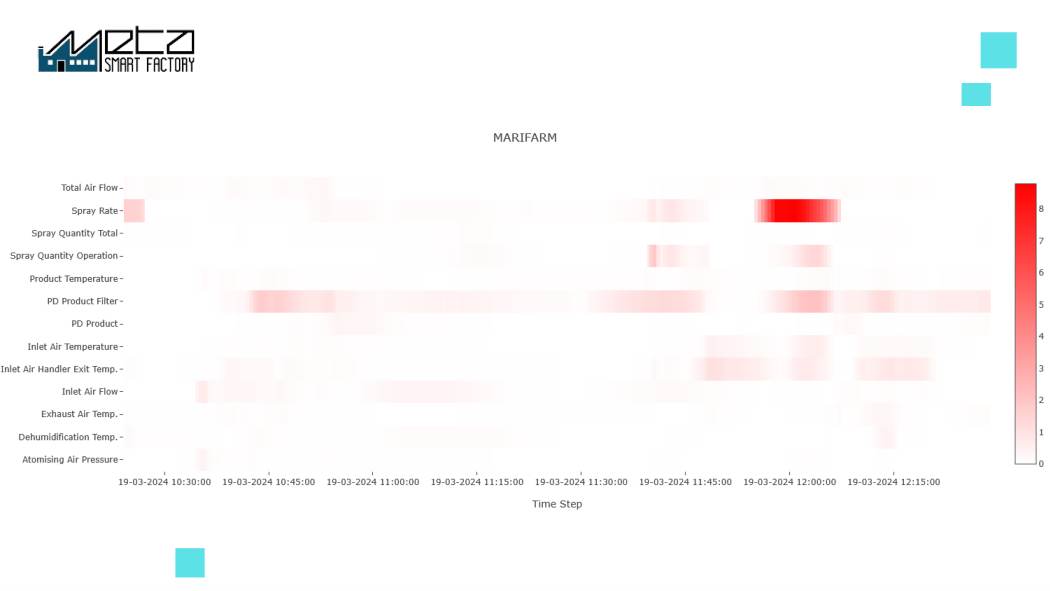
Ta učená s učitelem ne. Prediktivní kvalita potřebuje na jedné straně procesní parametry a na druhé skutečný výsledek jako značku, a sběrný kód zmetku na většině záznamů ji nenaučí nic. Nejdřív si v MES srovnejte odvádění zmetků a počítejte správně zaevidované kusy na jednotlivé kódy, ne uplynulé týdny. Mezitím můžete začít u detekce anomálií pomocí LSTM. Ta se učí bez učitele a žádné značky nepotřebuje; označí ale neobvyklé chování, konkrétní vadu nepojmenuje.
Mění AI parametry stroje sama od sebe?
Ne. Modely pro optimalizaci parametrů a plánu vydávají doporučení, která skončí před člověkem: na panelu, v reportu nebo jako návrh plánu v APS. Zápis čehokoli zpátky do řídicího systému stroje je samostatná integrace, kterou si zadáte vědomě. Pokud později opravdu chcete uzavřenou smyčku na nastavení stroje, berte to jako projekt řízení stroje s vlastním řízením změn, nikdy ne jako náhradu za hardwarově zapojené bezpečnostní blokace.
Kolik času zabere údržba AI modelů po náběhu?
Počítejte s konkrétním procesním nebo kvalitářským inženýrem a s pravidelným termínem na revizi; ladění a dotrénování dělá MSF, ale výsledek potřebuje svého vlastníka na vaší straně. Opakovaná práce je kontrola, že predikce pořád sedí na realitu, hlášení toho, že nový výrobek, změna nástroje nebo generálkovaný stroj posunuly proces, a udržování čistých kódů zmetků a prostojů. Není to práce na plný úvazek, ale není to ani nula.
Co se stane s modely, když změníme proces nebo najedeme nový výrobek?
Přesnost klesne, a klesne potichu. Model se naučil váš provoz v podobě, v jaké tehdy byl, takže nový materiál, přestavěný stroj nebo změněný takt znehodnotí část jeho historie, zatímco výstup pořád vypadá sebejistě. Plánované změny procesu nám řekněte dopředu a v projektu si natvrdo dohodněte, u kterých modelů se bude porovnávat predikce oproti skutečnosti, kdo to čte a jak často. Nepředpokládejte, že hlídání driftu běží u každého modelu automaticky.
Co je potřeba pro AI optimalizaci spotřeby energie?
Měření dost podrobné na to, aby šlo rozlišit jednotlivé spotřebiče, váš skutečný tarifní kalendář a plánovač, kterému může optimalizace předat plán; jeden elektroměr na vstupu do závodu vám řekne součet a nic o tom, kterou operaci přesunout. Optimalizace plánuje proti cenovým oknům energie a počítá v kWh. Udržet sjednaný rezervovaný příkon je jiná úloha. Potřebuje měření po čtvrthodinách a schopnost zátěž v danou chvíli podržet nebo odstavit, takže si ji zadejte zvlášť.
Jak přesné jsou predikce AI?
Jedno číslo přesnosti neexistuje. Model vydává skóre a to, kde nastavíte práh pro alarm, určuje zároveň záchytnost i podíl planých poplachů, měřeno na dílech, které model nikdy neviděl; volba toho bodu je obchodní rozhodnutí o tom, kolik stojí zastavený dobrý kus proti expedovanému zmetku. Významnost parametrů a korelace jsou diagnostika na úrovni modelu. Hodí se k odhalení zkratky, ale k posouzení jednoho konkrétního hlášení jsou nepoužitelné. Nechte to běžet naprázdno vedle provozu, dokud se nenasbírá dost skutečných vad na porovnání.
Další články
Související produkty
Připraveni vidět potenciál vaší továrny?
Získejte bezplatné demo a PoC plán na míru.