
KI- & Machine-Learning-Plattform
Ihre Fabrikdaten, in Entscheidungen verwandelt
Die MSF-KI-Plattform lernt aus Ihren Produktionsdaten, um Pläne zu optimieren, Qualitätsprobleme vorherzusagen, Nachfrage zu prognostizieren und verborgene Kapazität aufzudecken. Sie ist die Intelligenzschicht über allen MSF-Modulen.
Demo anfordernPoC startenWas ist eine KI-Plattform für die Fertigung?
Eine KI-Plattform für die Fertigung wendet maschinelles Lernen auf Produktionsdaten an, um Pläne zu optimieren, Qualitätsprobleme vorherzusagen, Nachfrage zu prognostizieren und auffälliges Maschinenverhalten zu erkennen. Die KI-Plattform von Meta Smart Factory ist die Intelligenzschicht über allen MSF-Modulen: Vorgefertigte Fertigungsmodelle werden von MSF-Experten auf die Daten des eigenen Werks abgestimmt, sodass kein internes Data-Science-Team nötig ist, und jedes Modell läuft im Schattenbetrieb, bevor ein Alarm scharfgeschaltet wird.
Zentrale Funktionen
Auf einen Blick
Technische Daten
- Datengrundlage
- MES-Daten aus der Fertigung sind Voraussetzung; jedes weitere Modul (APS, Quality, Maintenance) erschließt zusätzliche KI-Anwendungsfälle.
- Eingangsdaten der Modelle
- Überwachte Modelle (XGBoost-Feature-Importance, Ausbringungsprognose mit Random Forest) brauchen Prozessparameter und ein codiertes Ergebnis-Label; der LSTM-Autoencoder kommt mit reinen Sensorreihen aus.
- Betriebsmodell
- On-Premise oder in einer Private Cloud, Ihre Wahl; Ihre Produktionsdaten bleiben auf Ihre eigenen Modelle beschränkt.
- Ausgabeweg
- Ausschließlich Empfehlungen: auf einem Panel, in einem Report oder als Planvorschlag im APS. Das Zurückschreiben von Sollwerten in eine Steuerung ist eine eigens beauftragte Integration und niemals eine Sicherheitsverriegelung.
- Benötigte gelabelte Daten
- Überwachte Modelle bemessen sich in korrekt codierten Beispielen je Klasse und nicht in Monaten: Ausschussmodelle brauchen echte Ausschussgründe, Bedarfsprognosen mehrere vollständige Saisonzyklen.
- Voraussetzungen für die Energieoptimierung
- Eine Messung, die fein genug ist, um einzelne Verbraucher zu erkennen, Ihr Tarifkalender und ein Planungssystem, das den Plan entgegennimmt; optimiert wird ausschließlich gegen die kWh-Preisfenster.
- Aufwand auf Kundenseite
- Ein namentlich benannter Prozess- oder Qualitätsingenieur mit einem festen Termin im Kalender; MSF übernimmt Tuning und Nachtraining, der Kunde hält Ausschuss- und Stillstandsgründe sauber und meldet Prozessänderungen.
Aus der Plattform: echte Screens
Häufig gestellte Fragen
Benötige ich ein eigenes Data-Science-Team?
Nein. Die Modelle sind für Fertigungsanwendungsfälle vorgefertigt und werden von MSF-Experten auf Ihre Daten abgestimmt.
Wo liegen die Daten?
On-Premise oder in einer Private Cloud, ganz nach Ihrer Wahl. Ihre Produktionsdaten trainieren niemals die Modelle anderer Unternehmen.
Welche Module benötigt die KI?
MES-Daten bilden die Grundlage; jedes weitere Modul (APS, Quality, Maintenance) erschließt zusätzliche KI-Anwendungsfälle.
Wie viel Produktionshistorie braucht die KI?
Entscheidend ist die Anzahl gelabelter Beispiele je Klasse. Die Anzahl der Monate allein sagt wenig. Ein Ausschussmodell lernt aus Fehlern, eine Linie mit geringer Ausschussquote kann also sehr lange laufen, ohne genug Fälle der Minderheitsklasse zu liefern, während eine Bedarfsprognose mehrere vollständige Saisonzyklen sehen will. Ältere Historie zählt nur, wenn sie auf demselben Artikelstamm und derselben Werksstruktur liegt, für die Sie heute prognostizieren, also klären Sie zuerst, wann die letzte ERP-Migration oder Teilenummern-Umstellung war. Eine kurze saubere Reihe ist mehr wert als eine lange, die über eine Umnummerierung hinweg zusammengeflickt ist.
Funktioniert prädiktive Qualität auch ohne gepflegte Ausschussgründe?
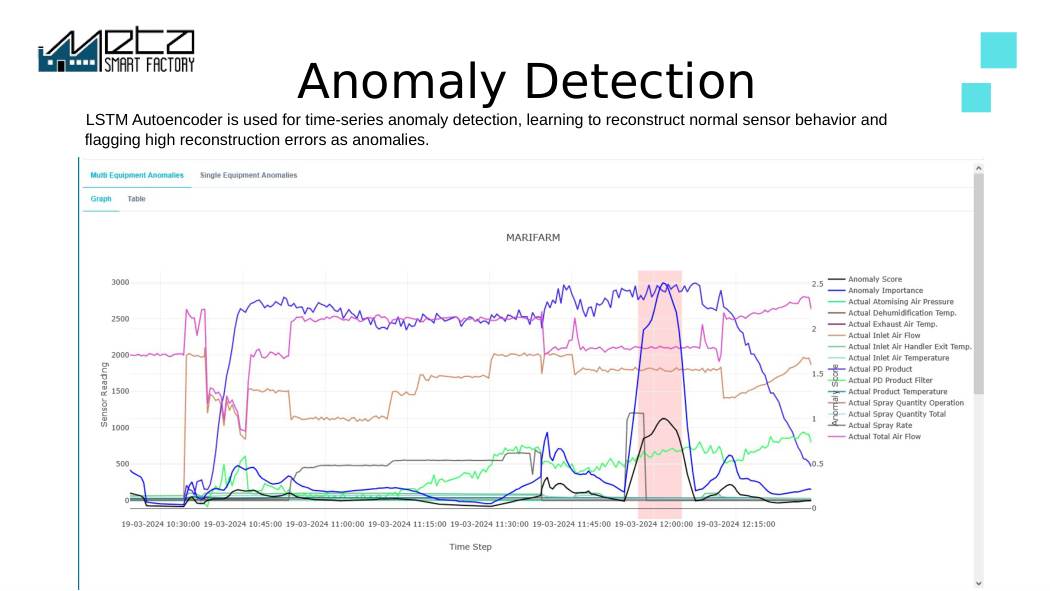
Das überwachte Lernen nicht. Prädiktive Qualität braucht auf der einen Seite Prozessparameter und auf der anderen ein echtes Ergebnis-Label, und ein Sammel-Ausschussgrund auf der Mehrheit der Datensätze bringt dem Modell nichts bei. Räumen Sie zuerst die Codierung im MES auf und zählen Sie korrekt codierte Fehler je Ausschussgrund. Vergangene Wochen sind dafür kein Maßstab. In der Zwischenzeit arbeitet die LSTM-Anomalieerkennung unüberwacht und braucht keine Labels, damit können Sie also anfangen, mit der Einschränkung, dass sie auffälliges Verhalten meldet und keinen benannten Fehler.
Verstellt die KI selbstständig Maschinenparameter?
Nein. Die Parameter- und Optimierungsmodelle erzeugen Empfehlungen, die vor einem Menschen landen, auf einem Panel, in einem Report oder als Planvorschlag im APS, und das Zurückschreiben in eine Steuerung ist eine eigene Integration, die Sie bewusst beauftragen. Wenn Sie später wirklich Sollwerte im geschlossenen Regelkreis wollen, behandeln Sie das als Automatisierungsprojekt mit eigenem Änderungsmanagement, und niemals als Ersatz für fest verdrahtete Sicherheitsverriegelungen.
Wie viel Aufwand macht die Pflege der KI-Modelle nach dem Go-live auf unserer Seite?
Planen Sie einen namentlich benannten Prozess- oder Qualitätsingenieur mit einem festen Termin im Kalender ein; MSF übernimmt Tuning und Nachtraining, aber das Ergebnis braucht einen Verantwortlichen bei Ihnen. Die laufende Arbeit besteht darin zu prüfen, ob die Vorhersagen noch zur Realität passen, zu melden, wenn ein neues Produkt, ein Werkzeugwechsel oder eine überholte Maschine den Prozess verschoben hat, und Ausschuss- und Stillstandsgründe sauber zu halten. Das ist kein Vollzeitjob, aber eben auch nicht nichts.
Was passiert mit den Modellen, wenn wir den Prozess ändern oder ein neues Produkt anfahren?
Die Treffsicherheit sinkt, und sie sinkt unauffällig. Ein Modell hat Ihr Werk so gelernt, wie es war, ein neues Material, eine umgebaute Maschine oder eine geänderte Taktzeit macht also einen Teil seiner Historie wertlos, während die Ausgabe weiterhin überzeugt aussieht. Sagen Sie uns geplante Prozessänderungen vorher an und legen Sie im Projekt fest, für welche Modelle ein Soll-Ist-Vergleich der Vorhersagen läuft, wer ihn liest und wie oft. Gehen Sie nicht davon aus, dass Drift-Überwachung bei jedem Modell standardmäßig aktiv ist.
Was braucht die KI-Energieoptimierung an Voraussetzungen?
Eine Messung, die fein genug ist, um einzelne Verbraucher zu identifizieren, Ihren tatsächlichen Tarifkalender und eine Planung, an die der Optimierer einen Vorschlag übergeben kann; ein einziger Zähler am Werkseingang liefert die Summe und keinerlei Hinweis darauf, welchen Arbeitsgang Sie verschieben sollten. Der Optimierer plant gegen Energiepreisfenster, gerechnet in kWh. Eine vereinbarte Leistungsspitze einzuhalten ist eine andere Aufgabe, dafür braucht es Messwerte im Lastgang und die Möglichkeit, eine Last im Moment zu halten oder abzuwerfen, das gehört also getrennt beauftragt.
Wie genau sind die Vorhersagen der KI?
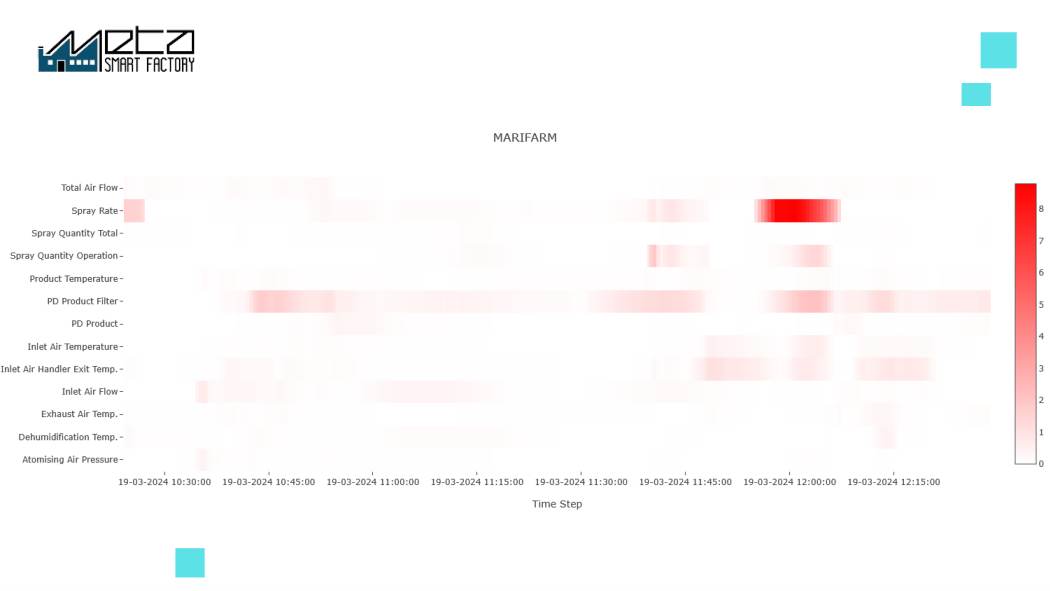
Eine einzelne Genauigkeitszahl gibt es nicht. Das Modell gibt einen Score aus, und wo Sie die Alarmschwelle setzen, legt sowohl die Trefferquote als auch die Fehlalarmquote fest, gemessen an Teilen, die das Modell nie gesehen hat; diesen Punkt zu wählen ist eine betriebswirtschaftliche Entscheidung darüber, was ein angehaltenes Gutteil gegenüber einem ausgelieferten Schlechtteil kostet. Feature Importance und Korrelation sind Diagnosen auf Modellebene, gut um eine Scheinkorrelation zu erkennen, aber unbrauchbar, um eine einzelne Meldung zu bewerten. Lassen Sie das Modell im Schattenbetrieb mitlaufen, bis genug echte Fehler für einen Vergleich zusammengekommen sind.
Weitere Artikel
Verwandte Produkte
Bereit, das Potenzial Ihrer Fabrik zu sehen?
Erhalten Sie eine kostenlose Demo und einen maßgeschneiderten PoC-Plan.