
什么是制造业 AI 平台?
制造业 AI 平台将机器学习应用于生产数据,用于优化排程、预测质量问题、预测需求并检测机器异常行为。Meta Smart Factory 的 AI 平台是贯穿所有 MSF 模块的智能层:预置的制造业模型由 MSF 专家基于工厂自身数据调优,企业无需组建内部数据科学团队;每个模型在告警正式上线前,都会先以影子模式运行。
核心功能
概览
技术规格
- 数据基础
- MES 执行数据是前提条件;每增加一个模块(APS、质量管理、设备维护),都会解锁更多 AI 应用场景。
- 模型输入
- 有监督模型(XGBoost 特征重要性、随机森林产量预测)既要工艺参数,也要有编码的结果标签;LSTM 自编码器只需要原始传感器序列。
- 部署方式
- 本地部署或私有云,由你自主决定;生产数据只进你自己的模型,不外流。
- 输出形式
- 只出建议:面板上的提示、一份报表,或者 APS 里的一版待确认排程。把设定值写回控制器属于另行立项的集成,任何情况下都不做安全联锁。
- 标注数据要求
- 有监督模型看的是每一类正确编码的样本有多少条,攒了几个月不算数:废品模型要有真实的废品原因代码,需求模型要有好几个完整的季节周期。
- 能耗优化前提
- 计量要细到能分出单台用电设备,要有你们实际执行的电价日历,还要有一个能接收计划的排程系统;它只按 kWh 电价时段做优化。
- 客户侧投入
- 指定一名工艺工程师或质量工程师,给他一个固定的复盘时间;调参和重新训练由 MSF 做,废品代码、停机代码的维护和工艺变更的通报由你们做。
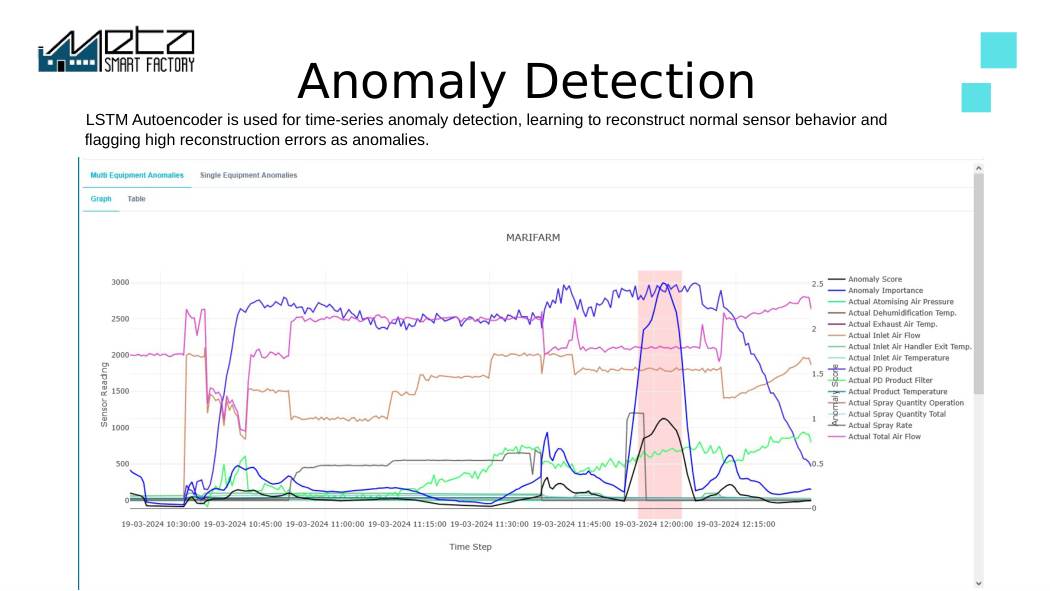
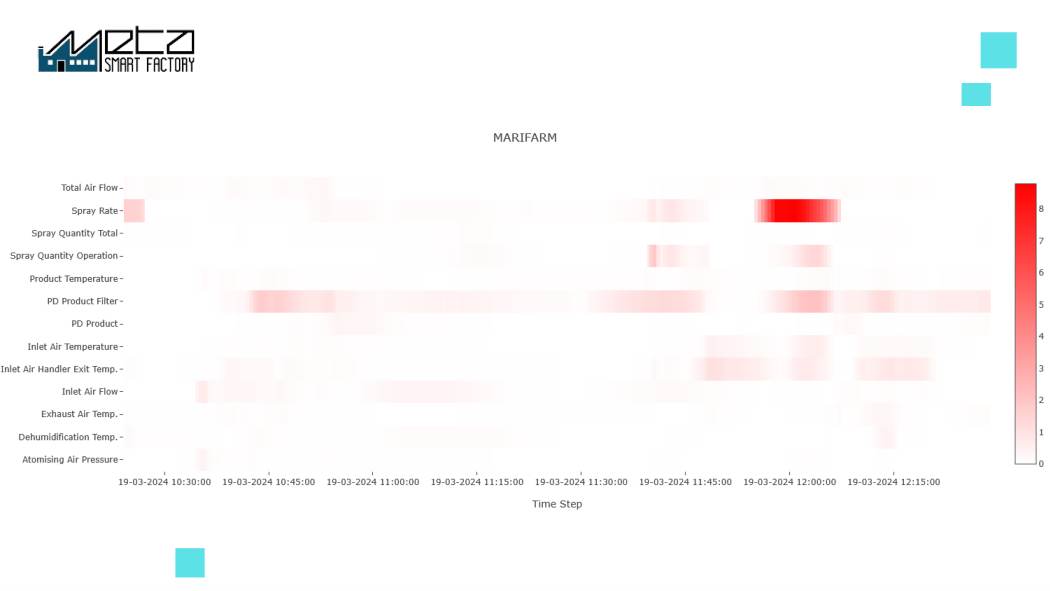
平台实景:真实界面截图
常见问题
需要自建数据科学团队吗?
不需要。模型已针对制造业应用场景预先构建完成,并由 MSF 专家团队基于您的数据进行调优。
数据存储在哪里?
可选择本地部署或私有云,由您自主决定。您的生产数据绝不会被用于训练其他公司的模型。
AI 平台需要依赖哪些模块?
MES 数据是基础;每增加一个模块(APS、质量管理、设备维护),都会解锁更多 AI 应用场景。
上 AI 需要积累多少历史生产数据?
关键看每一类有标注的样本有多少条,攒了几个月并不说明问题。废品预测模型是从不良里学的,不良率低的产线跑很久,少数类样本也凑不够训练量;需求预测模型则希望看到好几个完整的季节周期。老数据只有在物料主数据和工厂组织结构跟今天预测的口径一致时才算数,所以先查清楚上一次 ERP 切换或者料号重编是什么时候。一段干净的短序列,比一段跨过料号重编硬接起来的长序列有用。
没有废品原因代码,质量预测还能做吗?
有监督的那部分做不了。质量预测一边要工艺参数,一边要真实的结果标签,如果大部分记录的废品原因都选了那个万能的“其他”,模型什么也学不到。先把 MES 里的原因代码治理干净,衡量进度要看每个废品原因下正确分类的不良件数,治理了几周不说明问题。同时 LSTM 异常检测是无监督的,不需要标签,可以先从这里入手,前提是明白它报出来的是行为异常,说不出是哪一种具体缺陷。
AI 会自己去改机器参数吗?
不会。参数推荐和优化类模型输出的是建议,最终呈现给人看,可能是面板上的提示、一份报表,或者 APS 里的一版待确认排程;要把值写回控制器,属于另一件事,要单独立项评估。如果后面确实想做闭环设定值控制,就按控制项目来管,配套自己的变更管理流程,而且任何情况下都不能拿它替代硬接线的安全联锁。
上线之后维护这些 AI 模型,我们这边要投入多少人力?
要指定一名工艺工程师或质量工程师,给他一个固定的复盘时间;调参和重新训练由 MSF 做,但结果必须在你们这边有人认领。日常工作是核对预测跟实际还对不对得上,发现新产品、换了工装、大修过的机器让工艺发生了变化就及时提出来,以及把废品代码和停机代码维护干净。这不是一个全职岗位,但也绝不是没有工作量。
工艺改了或者上了新产品,原来的模型会怎么样?
准确率会下降,而且是悄无声息地下降。模型学的是当时那个状态的工厂,换了材料、机器大修过、节拍改了,历史数据里就有一部分失效了,但输出看上去还是那么笃定。工艺上有计划的变更请提前告诉我们,并且在项目里就把话说清楚:哪些模型要做预测值与实际值的对比、谁来看、多久看一次,不要默认每个模型都开着漂移监控。
AI 能耗优化需要具备哪些条件?
计量要细到能分出单台用电设备,要有你们实际执行的电价日历,还要有一个能接收计划的排程系统;只在厂区总进线装一块表,只能告诉你总用了多少,说不出该挪哪道工序。优化器排的是电价时段,算的是 kWh。至于守住合同约定的最大需量,那是另一回事,需要分钟级的间隔计量,还要能在当下把负荷压下来或者切掉,请单独立项。
AI 预测的准确率能到多少?
没有一个通用的准确率数字。模型输出的是一个分数,报警阈值定在哪里,就同时决定了检出率和误报率,而且要拿模型没见过的零件来验证;这个点定在哪,本质上是个业务决策,要权衡拦下一个好件的损失和流出一个不良件的代价。特征重要性和相关性属于模型层面的诊断手段,适合发现模型抄了近道,但判断某一次报警准不准没有用。建议先用影子模式跑着,等真实不良攒够了再做比对。
更多文章
相关产品
准备好了解您工厂的潜力了吗?
获取免费演示和为您量身定制的概念验证方案。