
Plateforme IA & Machine Learning
Les données de votre usine, transformées en décisions
La plateforme IA de MSF apprend de vos données de production pour optimiser les plannings, prédire les problèmes qualité, prévoir la demande et révéler les capacités cachées. C’est la couche d’intelligence au-dessus de tous les modules MSF.
Demander une démoLancer un PoCQu’est-ce qu’une plateforme d’IA industrielle ?
Une plateforme d’IA industrielle applique l’apprentissage automatique aux données de production pour optimiser les plannings, prédire les problèmes qualité, prévoir la demande et détecter les anomalies machine. Celle de Meta Smart Factory, couche d’intelligence de tous les modules MSF, fournit des modèles industriels préconçus que les experts MSF ajustent sur les données de l’usine, sans équipe interne de science des données ; chaque modèle tourne en parallèle avant toute alerte.
Fonctionnalités clés
En un coup d’œil
Caractéristiques techniques
- Socle de données
- Les données d’exécution du MES sont le prérequis ; chaque module supplémentaire (APS, Qualité, Maintenance) débloque de nouveaux cas d’usage IA.
- Entrées des modèles
- Les modèles supervisés (importance des variables XGBoost, prédiction de rendement Random Forest) réclament des paramètres process et un label de résultat codé ; l’autoencodeur LSTM se contente des séries brutes de capteurs.
- Déploiement
- Sur site ou dans un cloud privé, à votre choix ; vos données de production restent isolées dans vos propres modèles.
- Nature des sorties
- Des recommandations uniquement : un panneau, un rapport ou une proposition d’ordonnancement dans l’APS. Écrire des consignes dans un automate est une intégration cadrée à part, et jamais une sécurité câblée.
- Données étiquetées nécessaires
- Les modèles supervisés se dimensionnent en exemples correctement codés par classe, pas en mois : un modèle de rebut réclame de vrais codes motif de rebut, un modèle de demande plusieurs cycles saisonniers complets.
- Prérequis pour l’optimisation énergétique
- Un comptage assez fin pour identifier les consommateurs un par un, votre calendrier tarifaire et un ordonnanceur pour recevoir le plan ; l’optimisation porte uniquement sur les créneaux de prix du kWh.
- Charge côté client
- Un ingénieur process ou qualité nommément désigné, avec un créneau de revue récurrent : MSF assure le réglage et le réentraînement, le client garde propres les codes de rebut et d’arrêt et signale les changements process.
Depuis la plateforme : écrans réels
Questions fréquentes
Ai-je besoin d’une équipe data science ?
Non. Les modèles sont pré-conçus pour les cas d’usage industriels et calibrés par les experts MSF sur vos propres données.
Où résident les données ?
Sur site ou dans un cloud privé, à votre choix. Vos données de production n’entraînent jamais les modèles d’autres entreprises.
De quels modules l’IA a-t-elle besoin ?
Les données du MES constituent le socle ; chaque module supplémentaire (APS, Qualité, Maintenance) débloque de nouveaux cas d’usage IA.
Combien d’historique de production faut-il pour entraîner l’IA ?
Ce qui compte, c’est le nombre d’exemples étiquetés par classe. Le nombre de mois écoulés importe peu. Un modèle de rebut apprend à partir des défauts : une ligne qui rebute peu peut tourner longtemps sans produire assez d’occurrences de la classe minoritaire pour être entraînée, alors qu’un modèle de prévision de la demande réclame plusieurs cycles saisonniers complets. L’historique ancien ne compte que s’il repose sur la même codification articles et la même structure de sites que celle sur laquelle vous prévoyez aujourd’hui : commencez donc par retrouver votre dernière migration ERP ou votre dernier changement de référence. Une série courte et propre vaut mieux qu’une série longue recollée de part et d’autre d’un renumérotage.
La qualité prédictive fonctionne-t-elle sans codes motif de rebut ?
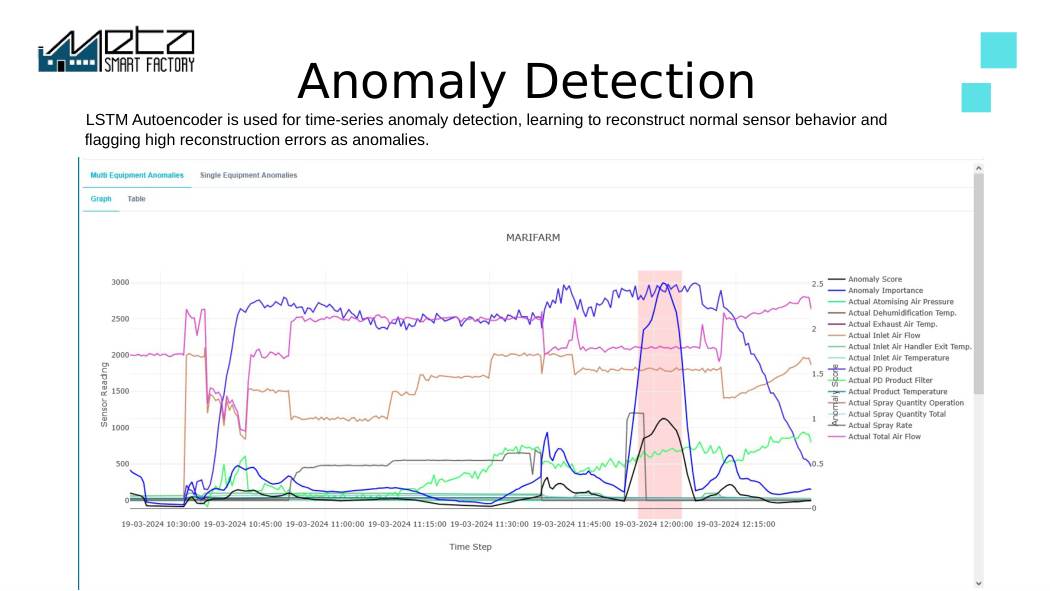
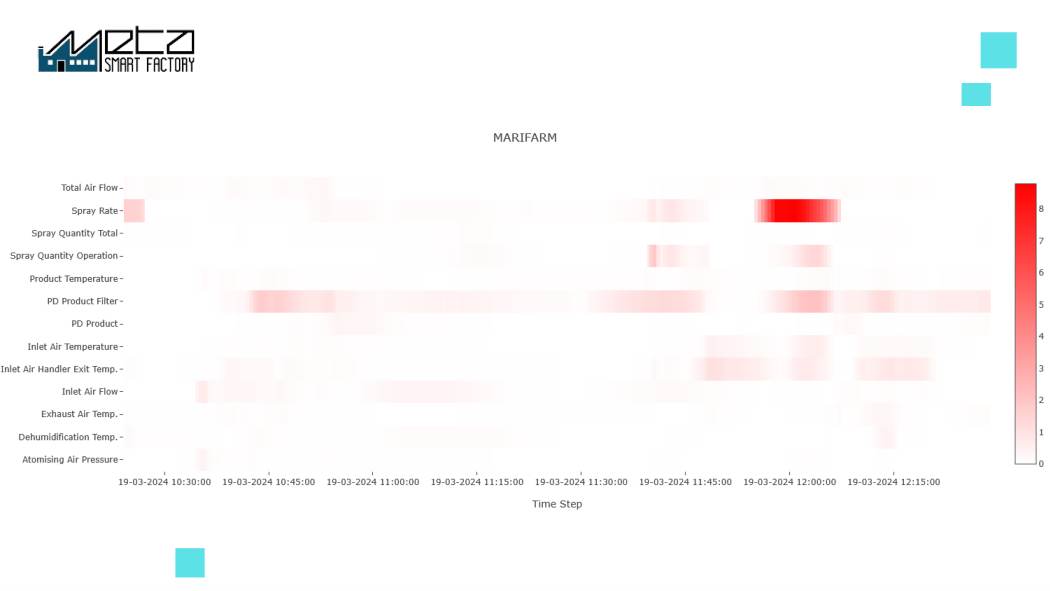
Pas la partie supervisée. La qualité prédictive a besoin des paramètres process d’un côté et d’un vrai label de résultat de l’autre, et un motif de rebut fourre-tout sur la majorité des enregistrements ne lui apprend rien. Reprenez d’abord la codification dans le MES, et comptez les défauts correctement codés par motif de rebut ; les semaines écoulées ne disent rien. En attendant, la détection d’anomalies par LSTM est non supervisée et n’a besoin d’aucun label. Vous pouvez démarrer par là, en gardant en tête qu’elle signale un comportement inhabituel sans nommer de défaut.
L’IA modifie-t-elle les paramètres machine toute seule ?
Non. Les modèles de paramètres et d’optimisation produisent des recommandations qui arrivent devant quelqu’un : sur un panneau, dans un rapport, ou sous forme de proposition d’ordonnancement dans l’APS. Écrire quoi que ce soit dans un automate est une intégration distincte, que l’on cadre délibérément. Si vous voulez plus tard des consignes en boucle fermée, traitez-le comme un projet d’automatisme avec sa propre conduite du changement, et jamais comme un substitut aux sécurités câblées.
Quelle charge de travail représente la maintenance des modèles IA après la mise en service ?
Prévoyez un ingénieur process ou qualité nommément désigné, avec un créneau de revue récurrent : MSF assure le réglage et le réentraînement, mais le résultat doit avoir un propriétaire chez vous. Le travail récurrent consiste à vérifier que les prédictions collent toujours au réel, à signaler qu’un nouveau produit, un changement d’outillage ou une machine rétrofitée a déplacé le process, et à garder propres les codes de rebut et d’arrêt. Ce n’est pas un poste à temps plein, mais ce n’est pas rien non plus.
Que deviennent les modèles quand on change le process ou qu’on lance un nouveau produit ?
La précision baisse, et elle baisse sans bruit. Un modèle a appris votre usine telle qu’elle était : une nouvelle matière, une machine reconstruite ou un temps de cycle modifié rendent une partie de son historique caduque alors que la sortie continue d’avoir l’air sûre d’elle. Annoncez-nous les changements process à l’avance, et fixez dans le projet quels modèles font l’objet d’une comparaison prédit/réalisé, qui la lit et à quelle fréquence. Ne supposez pas que la surveillance de la dérive est activée par défaut sur tous les modèles.
Que faut-il en place pour faire de l’optimisation énergétique par IA ?
Un comptage assez fin pour identifier les consommateurs un par un, votre calendrier tarifaire réel, et un ordonnanceur auquel l’optimiseur puisse remettre un plan : un seul compteur en tête d’usine vous donne le total et ne dit rien sur l’opération à décaler. Ce sur quoi l’optimiseur raisonne, ce sont les créneaux de prix de l’énergie, mesurés en kWh. Tenir un plafond de puissance souscrite est un autre métier, qui suppose une mesure au pas de temps court et la capacité de retenir ou d’effacer une charge dans l’instant : cadrez-le séparément.
Quelle est la précision des prédictions de l’IA ?
Il n’existe pas de chiffre de précision unique. Le modèle sort un score, et l’endroit où vous placez le seuil d’alerte fixe à la fois le taux de détection et le taux de fausses alertes, mesurés sur des pièces que le modèle n’a jamais vues ; choisir ce point est une décision de gestion, entre ce que coûte une bonne pièce arrêtée et ce que coûte une mauvaise pièce expédiée. La corrélation et l’importance des variables sont des diagnostics au niveau du modèle : utiles pour repérer un raccourci trompeur, inutiles pour juger une alerte prise isolément. Faites tourner le modèle en parallèle, sans effet sur la production, jusqu’à ce qu’assez de défauts réels se soient accumulés pour comparer.
Autres articles
Produits associés
Prêt à voir le potentiel de votre usine ?
Obtenez une démo gratuite et un plan de PoC sur mesure.