
Platforma umetne inteligence in strojnega učenja
Podatki vaše tovarne, spremenjeni v odločitve
Platforma UI podjetja MSF se uči iz vaših proizvodnih podatkov, da optimizira urnike, napove težave s kakovostjo, napove povpraševanje in razkrije skrite zmogljivosti. Je plast inteligence nad vsemi moduli MSF.
Zahtevaj demoZačni PoCKaj je platforma umetne inteligence (AI) za proizvodnjo?
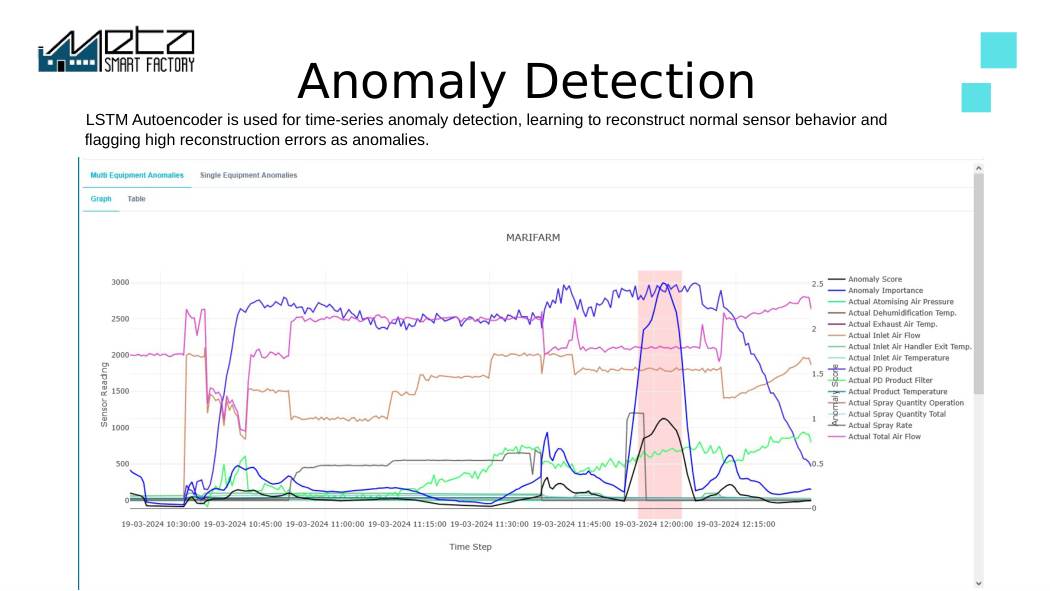
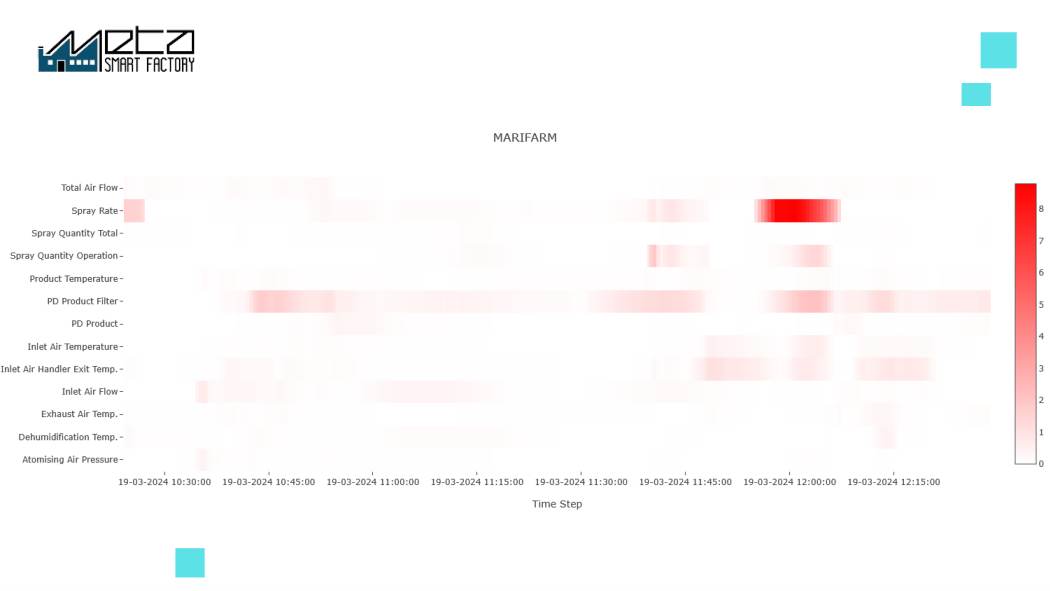
Platforma umetne inteligence za proizvodnjo s strojnim učenjem na proizvodnih podatkih optimizira urnike, predvidi težave s kakovostjo, napove povpraševanje in zazna nenormalno delovanje strojev. Platforma UI podjetja Meta Smart Factory je plast inteligence nad vsemi moduli MSF: vnaprej pripravljene proizvodne modele strokovnjaki MSF prilagodijo na lastnih podatkih obrata, zato lastna ekipa podatkovnih znanstvenikov ni potrebna, vsak model pa najprej deluje v senčnem načinu, preden se opozorila zares vklopijo.
Ključne funkcije
Na prvi pogled
Tehnični podatki
- Podatkovni temelj
- Pogoj so izvedbeni podatki iz MES; vsak dodatni modul (APS, Quality, Maintenance) odpre nadaljnje možnosti uporabe UI.
- Vhodi modelov
- Nadzorovani modeli (pomembnost spremenljivk XGBoost, napoved izkoristka z Random Forest) potrebujejo procesne parametre in šifrirano oznako izida; avtokodirnik LSTM potrebuje le surove nize senzorskih vrednosti.
- Namestitev
- Lokalno ali v zasebnem oblaku, odločitev je vaša; proizvodni podatki ostanejo ločeni znotraj vaših lastnih modelov.
- Pot rezultata
- Samo priporočila: plošča, poročilo ali predlagan urnik v APS. Pisanje nastavitvenih vrednosti nazaj v krmilnik je ločeno opredeljena integracija in nikoli varnostna blokada.
- Potrebni označeni podatki
- Nadzorovani modeli se merijo v številu pravilno šifriranih primerov na razred in ne v mesecih: modeli izmeta potrebujejo resnične šifre vzrokov izmeta, modeli povpraševanja pa več celih sezonskih ciklov.
- Pogoji za energetiko
- Merjenje, dovolj podrobno, da prepozna posamezne porabnike, vaš tarifni koledar in razvrščevalnik, ki načrt sprejme; optimizira izključno glede na cenovna okna, merjena v kWh.
- Delo na strani stranke
- Imenovan procesni ali kakovostni inženir s stalnim terminom za pregled; MSF uglašuje in ponovno uči modele, stranka pa vzdržuje čiste šifre izmeta in zastojev ter javlja spremembe procesa.
Iz platforme: resnični zasloni
Pogosta vprašanja
Ali potrebujem lastno ekipo podatkovnih znanstvenikov?
Ne. Modeli so že pripravljeni za primere uporabe v proizvodnji, strokovnjaki MSF pa jih uglasijo na vaših podatkih.
Kje se hranijo podatki?
Lokalno ali v zasebnem oblaku, odločitev je vaša. Vaši proizvodni podatki nikoli ne služijo za učenje modelov drugih podjetij.
Katere module UI potrebuje?
Temelj so podatki iz MES; vsak dodatni modul (APS, Quality, Maintenance) odpre nove možnosti uporabe UI.
Koliko zgodovine proizvodnje potrebuje UI?
Šteje število označenih primerov na razred, ne to, koliko mesecev nazaj sega zgodovina. Model izmeta se uči iz napak, zato lahko linija z malo izmeta teče zelo dolgo in vseeno ne nabere dovolj primerov manjšinskega razreda za učenje, model napovedi povpraševanja pa hoče več celih sezonskih ciklov. Starejša zgodovina šteje le, če stoji na isti šifri artikla in isti strukturi obrata, kot jo napovedujete danes, zato najprej poiščite zadnjo migracijo ERP ali prešifriranje kosov. Kratka in čista serija je boljša od dolge, zlepljene čez prešifriranje.
Ali prediktivna kakovost deluje brez šifer vzrokov izmeta?
Nadzorovani del ne. Prediktivna kakovost potrebuje procesne parametre na eni strani in resnično oznako izida na drugi, splošna zbirna šifra izmeta na večini zapisov pa je ne nauči ničesar. Najprej uredite šifriranje v MES in štejte pravilno šifrirane napake po posameznem vzroku izmeta, ne pretečenih tednov. Medtem je zaznavanje anomalij z LSTM nenadzorovano in oznak ne potrebuje, zato lahko začnete tam, s pridržkom, da označi neobičajno vedenje, ne poimenovane napake.
Ali UI sama spreminja parametre stroja?
Ne. Modeli za parametre in optimizacijo dajejo priporočila, ki pridejo pred človeka, na ploščo, v poročilo ali kot predlagan urnik v APS, pisanje nazaj v krmilnik pa je ločena integracija, ki jo zavestno opredelite. Če kasneje res želite zaprto zanko z nastavitvenimi vrednostmi, to vzemite kot regulacijski projekt z lastnim obvladovanjem sprememb in nikoli kot nadomestilo za ožičene varnostne zapore.
Koliko našega časa vzame vzdrževanje modelov UI po zagonu?
Predvidite imenovanega procesnega ali kakovostnega inženirja s stalnim terminom za pregled; uglaševanje in ponovno učenje opravi MSF, rezultat pa potrebuje skrbnika na vaši strani. Ponavljajoče se delo je preverjanje, ali napovedi še sledijo dejanskemu stanju, javljanje, kdaj je nov izdelek, sprememba orodja ali generalno obnovljen stroj premaknil proces, ter vzdrževanje čistih šifer izmeta in zastojev. Ni delo za polni delovni čas, ni pa tudi zanemarljivo.
Kaj se zgodi z modeli, ko spremenimo proces ali uvedemo nov izdelek?
Natančnost pade, in pade tiho. Model se je naučil vaše tovarne, kakršna je bila, zato nov material, predelan stroj ali spremenjen cikel del njegove zgodovine naredijo nepomemben, izhod pa je še vedno videti prepričljiv. O načrtovanih spremembah procesa nam povejte vnaprej in v projektu določite, kateri modeli dobijo primerjavo napovedano proti dejansko, kdo jo bere in kako pogosto. Ne predpostavljajte, da je spremljanje odmika privzeto vklopljeno za vsak model.
Kaj potrebuje optimizacija porabe energije z UI?
Merjenje, dovolj podrobno, da prepozna posamezne porabnike, vaš dejanski tarifni koledar in razvrščevalnik, ki mu optimizator lahko preda načrt; en števec na vstopu v obrat pove skupno porabo in nič o tem, katero operacijo premakniti. Optimizator načrtuje glede na cenovna okna energije, merjeno v kWh. Ostati pod dogovorjeno obračunsko močjo je druga naloga, ki zahteva intervalno merjenje in sposobnost, da porabnik v danem trenutku zadržite ali odklopite, zato to opredelite posebej.
Kako natančne so napovedi UI?
Ene same številke natančnosti ni. Model daje oceno, kje postavite prag opozorila, pa določi tako delež ujetih primerov kot delež lažnih alarmov, merjeno na kosih, ki jih model ni nikoli videl; izbira te točke je poslovna odločitev o tem, koliko stane zaustavljen dober kos proti odpremljenemu slabemu. Pomembnost spremenljivk in korelacija sta diagnostiki na ravni modela, dobri za lovljenje bližnjic, neuporabni pa za presojo posamezne označitve. Naj nekaj časa teče vzporedno in brez posledic, dokler se ne nabere dovolj resničnih napak za primerjavo.
Več člankov
Sorodni izdelki
Pripravljeni videti potencial svoje tovarne?
Pridobite brezplačno predstavitev in PoC načrt po meri.