
Platforma Chmurowa SaaS i Wdrożenie
Bezpieczeństwo klasy enterprise, model wdrożenia do wyboru
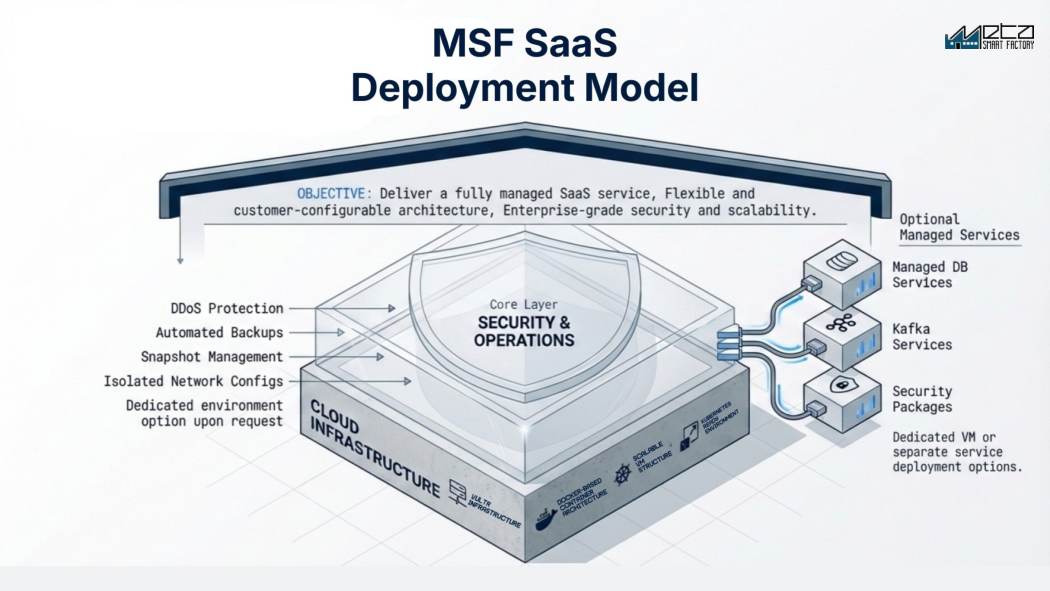
MSF działa tak, jak wymaga tego Twoja polityka IT: w pełni zarządzany SaaS w chmurze, dedykowane środowisko single-tenant albo on-premise. Architektura oparta na Dockerze i Kubernetes z bezpieczeństwem klasy enterprise. Ochrona DDoS, automatyczne kopie, snapshoty i izolowane sieci są w standardzie.
Poproś o demoRozpocznij PoCJakie modele wdrożenia oferuje platforma Meta Smart Factory?
Platformę Meta Smart Factory można wdrożyć na trzy sposoby: jako współdzielony SaaS multi-tenant dla MŚP i szybkiego startu, jako dedykowane środowisko single-tenant z własną VM i bazą danych dla rygorystycznych polityk bezpieczeństwa IT albo on-premise we własnym centrum danych zakładu. Wszystkie trzy działają na tej samej platformie opartej na Dockerze i Kubernetes, z ochroną DDoS, automatycznymi kopiami zapasowymi i izolowanymi sieciami; wdrożenia hostowane działają na europejskiej infrastrukturze chmurowej.
Kluczowe funkcje
Oceny i wyzwania
W skrócie
Dane techniczne
- Modele wdrożenia
- Współdzielony SaaS multi-tenant, dedykowany single-tenant z osobną maszyną wirtualną i bazą danych albo on-premise we własnym centrum danych. W każdym z trzech ta sama platforma.
- Architektura
- Oparta na kontenerach Docker, struktura maszyn wirtualnych gotowa pod Kubernetes, skalowalna horyzontalnie. Opcjonalne zarządzane usługi bazodanowe, strumieniowanie Kafka i pakiety bezpieczeństwa jako osobne wdrożenia.
- Hosting i lokalizacja danych
- Europejska infrastruktura chmurowa, z opcjami dedykowanego środowiska i regionu na życzenie. Dane produkcyjne zostają w Waszym środowisku (tenant) i nigdy nie trenują modeli innych firm.
- Łącze do zakładu
- Kolektor postawiony w sieci zakładowej odczytuje sterowniki i sam nawiązuje połączenie; transmisja idzie po TLS albo tunelem site-to-site VPN, bez portu nasłuchującego od strony internetu.
- Bezpieczeństwo
- Ochrona przed atakami DDoS, automatyczne kopie zapasowe, zarządzanie migawkami i izolowane konfiguracje sieciowe w każdym wdrożeniu: współdzielonym, dedykowanym i on-premise.
- Aktualizacje
- Wydania kroczące bez wyłączania platformy, ale ekran może się przeładować albo poprosić o ponowne logowanie, a niezapisane dane przepaść; migracja schematu bazy może wymagać okna serwisowego.
- Wymagania przed wdrożeniem on-premise
- Wymiarowane podczas PoC: serwery pod kupowane moduły, moc GPU dla wizji maszynowej lub AI, VLAN dla warstwy sterowania, reguły firewalla, DNS, certyfikaty, kopie zapasowe z testami odtworzenia.
- Dostępność i monitoring
- Docelowa dostępność 99,9% dla platformy hostowanej, którą my utrzymujemy, z monitoringiem 24/7; Wasze łącze, firewall, kolektor i maszyny są poza tym parametrem. Przy on-premise dostępność jest po Waszej stronie.
Z platformy: prawdziwe ekrany
Najczęstsze pytania
Który model wdrożenia wybrać?
MŚP i szybkie wdrożenia: współdzielony SaaS. Duże przedsiębiorstwa z rygorystycznymi politykami bezpieczeństwa lub głęboką integracją PLC/VPN: dedykowany single-tenant lub on-premise. Doradzamy w tej kwestii podczas PoC.
Gdzie hostowane są dane?
Na europejskiej infrastrukturze chmurowej, z opcjami dedykowanego środowiska i regionu na życzenie.
Czy mogę później zmienić model?
Tak. Zacznij od modelu współdzielonego dla szybkości, a w miarę rozwoju przejdź na dedykowany lub on-premise. Platforma pozostaje identyczna.
Co się dzieje na hali, gdy padnie nam łącze internetowe?
We wdrożeniu chmurowym kolektor stojący w zakładzie dalej odczytuje maszyny i buforuje lokalnie liczniki oraz rejestr postojów, a po powrocie łącza odtwarza je do platformy; jak długo utrzyma bufor, zależy od konkretnego wdrożenia i ustala się to podczas PoC. Wszystko, co dostarcza platforma, staje natychmiast: dashboardy, zwalnianie nowych zleceń, ekrany raportowe. Wszystko, co operator musi wpisać ręcznie, wraca na papier do czasu odtworzenia łącza, więc przed go-live ustalcie tryb awaryjny dla przyczyn postoju i braków. Podczas PoC po prostu wypnijcie kabel i sprawdźcie.
Czy opcja chmurowa oznacza wystawienie naszych sterowników PLC do internetu?
Nie. Kolektor stoi wewnątrz sieci zakładowej, odczytuje sterowniki i sam nawiązuje połączenie wychodzące po TLS albo tunelem site-to-site VPN, więc na firewallu nie otwiera się żadnego portu w stronę zakładu. Trzeba jednak jasno określić, co ten kolektor może robić: jest zaufanym mostem, a każdy zapis, który platforma może mu zlecić w stronę sterowników, to ta sama droga do środka, tylko inaczej nazwana. Segmentacja warstwy sterowania to już Wasz projekt sieci, więc niech zespół przejrzy adresy docelowe, porty i uprawnienia do zapisu jeszcze przed PoC.
Czym musi zarządzać nasze IT, jeśli postawimy to on-premise?
Na Waszej stronie zostają serwery, systemy operacyjne, platforma kontenerowa, baza danych, kopie zapasowe wraz z testami odtworzenia, certyfikaty i ich odnawianie, monitoring oraz okna aktualizacyjne. To oznacza konkretną osobę z doświadczeniem w Linuksie i kontenerach. Obowiązek rozdzielony po zajętym zespole tego nie zastąpi. Jest tego więcej, niż zakłada budżet większości kupujących, a jeśli nikt w firmie nie pasuje do tego opisu, on-premise jest dla Was złym wyborem.
Czy aktualizacje bez przestoju faktycznie nie przerywają pracy użytkownikom?
Bez przestoju znaczy tylko tyle, że platformy nie wyłącza się na czas wydania. Nie jest to obietnica, że nic nigdy się nie przerwie. Podczas aktualizacji kroczącej ekran może się przeładować i, zależnie od sposobu zalogowania terminala, poprosić o ponowne logowanie, a niezapisane dane w otwartym formularzu mogą przepaść. Migracja schematu bazy albo wersja zmieniająca sposób raportowania i tak może wymagać zaplanowanego okna serwisowego. Ustalcie, kto jest informowany przed wydaniem i jak wygląda wycofanie wersji.
Co trzeba przygotować przed instalacją on-premise?
Najpierw decyzje o sprzęcie i sieci: serwery zwymiarowane pod kupowane moduły, moc GPU, jeśli bierzecie wizję maszynową lub AI, osobny VLAN dla warstwy sterowania, reguły firewalla między nią a aplikacją, wpisy DNS, certyfikaty i miejsce na kopie zapasowe z osobą odpowiedzialną za testy odtworzenia. Do tego imienne konta administracyjne i uzgodnione okno serwisowe. To właśnie braki na tej liście opóźniają go-live znacznie częściej niż samo oprogramowanie.
Co obejmuje deklarowana dostępność 99,9%?
Platformę, którą my utrzymujemy, i wyłącznie wdrożenia hostowane; przy on-premise dostępność jest po Waszej stronie. Wasze łącze, Wasz firewall, kolektor w zakładzie i same maszyny są poza tym parametrem, a w praktyce to one odpowiadają za większość tego, co na hali odbiera się jako awarię. Dopytajcie, jak dostępność jest mierzona, co liczy się jako planowana przerwa serwisowa, z jakiego okresu liczony jest wskaźnik i co przysługuje przy jego niedotrzymaniu, i wpiszcie te definicje do umowy.
Czy dane naszych operatorów to dane osobowe w rozumieniu RODO?
Tak. Systemy na hali zapisują, kto zalogował się na którym stanowisku i ile trwała operacja, więc platformę da się eksploatować zgodnie z prawem, ale samo wdrożenie zgodności Wam nie załatwia. Potrzebna jest umowa powierzenia przetwarzania, okres retencji i decyzja, kto może oglądać wyniki indywidualne, a kto tylko zagregowane. Dopytajcie, czy raportowanie na poziomie pojedynczego pracownika da się ograniczyć rolą albo wyłączyć, i włączcie dział prawny oraz HR na wczesnym etapie, bo przed go-live zwykle konsultuje się to z przedstawicielami załogi.
Więcej artykułów
Powiązane produkty
Gotowy zobaczyć potencjał swojej fabryki?
Otrzymaj bezpłatne demo i plan PoC dopasowany do Twojej produkcji.